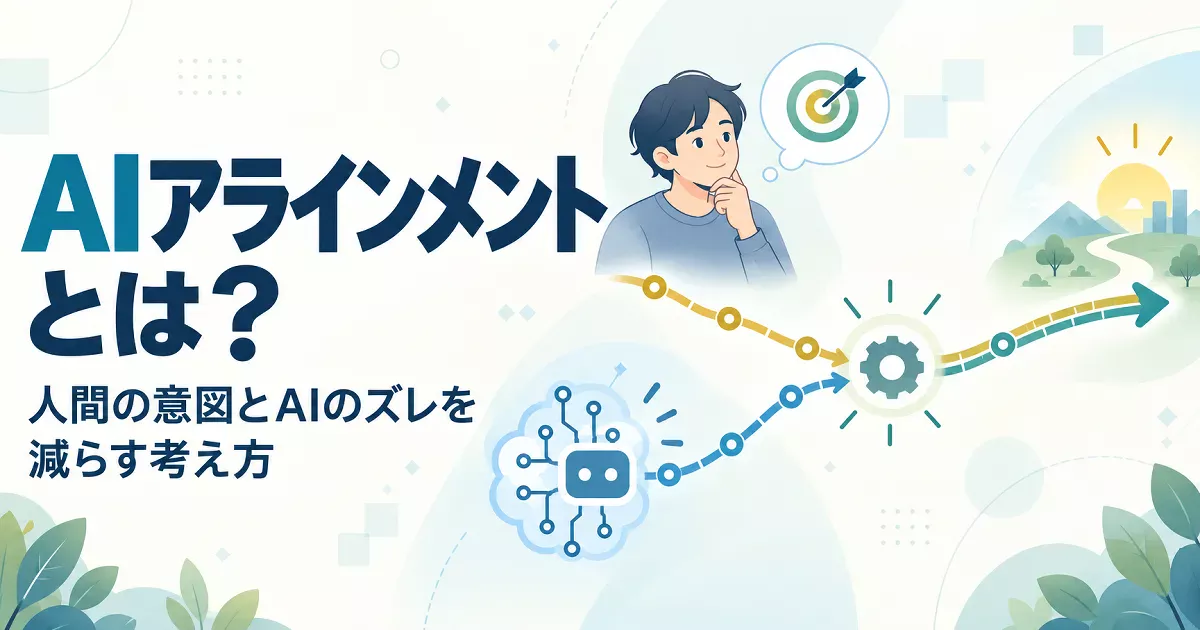
AIに「希望どおりの答えを出してほしい」と頼んでも、人間が頭の中で思い描いている目的まで自動的に理解してくれるとは限りません。
指示どおりに動いているように見えても、言葉を必要以上に文字どおり受け取ったり、与えられた評価基準だけを追いかけたりすれば、本当に望んでいた結果から外れることがあります。
こうしたズレを小さくし、AIの目的や振る舞いを人間の意図や重視する価値に近づけようとする考え方が「AIアラインメント」です。
一方で、「何をもって人間に合っているとするのか」は簡単には決まりません。AIを高性能にするだけでは解決できない、技術と人間社会の両方にまたがるテーマです。
AIアラインメントとは人間とAIのズレを小さくする考え方
「アラインメント(alignment)」には、「整合」「一致」「そろえる」といった意味があります。
AIの分野では一般に、AIシステムの目的や振る舞いを、人間の意図・価値・望ましい結果とできるだけ一致させることを指します。
たとえば「文章を短くまとめて」と頼んだとき、文字数を減らすことだけを優先して重要な内容まで落としてしまえば、形式的には「短くする」という指示に従っていても、利用者が欲しかった要約とは違います。
AIアラインメントが扱うのは、このような「与えた指示」と「本当に求めていた結果」のズレです。
ただ、AIアラインメントという言葉が指す範囲は、研究者や組織によって多少異なります。利用者の指示への対応を中心に考える場合もあれば、人間の価値、安全性、人間による監督まで含めて広く扱う場合もあります。
Google DeepMindも、価値をAIへどう組み込むかという技術上の問題だけでなく、そもそも「どの価値を採用するのか」という問題があると論じています。
AIアラインメントは、単純に「AIを命令どおりに動かすこと」だけを意味する言葉ではありません。
なぜAIは人間の意図とずれることがある?
AIが人間の意図から外れたからといって、AIが意図的に反抗しているとは限りません。
人間が望んでいることを、機械が扱える指示や評価基準として完全に表すことが難しいためです。
指示の言葉だけでは本当の目的まで表せない
人間同士でも、「いい感じにまとめて」「なるべく早く」といった言葉の意味が完全には一致しないことがあります。
AIへの指示でも似た問題が起こります。
「最も効率よく」
「できるだけ多く」
「高い評価を得るように」
といった目標を与えても、人間が暗黙のうちに想定している条件まで自動的に含まれるとは限りません。
人間なら避けると思っている方法でも、その条件が指示や評価基準に含まれていなければ、AI側では選択肢として残る可能性があります。
条件を守っていても本来の目的から外れることがある
AIを学習させるには、何が良くて何が悪いのかを何らかの形で評価する必要があります。
ところが、人間が本当に求めているものを直接測れない場合、点数や報酬など、代わりとなる基準を使うことがあります。
そこで起こり得るのが、設定された基準は満たしているのに、人間が望んでいた結果にはなっていないというズレです。
AI研究では、このように文字どおりの仕様を満たしながら本来の意図から外れる振る舞いを「specification gaming」と呼ぶことがあります。設定された仕様の抜け道を使うような振る舞いです。
Google DeepMindが紹介する例では、AIが与えられた報酬を増やす方法を見つけても、それが人間の想定していた課題の解き方とは異なる場合があります。
たとえば「利用時間が長いほど高評価」という基準だけを置けば、利用者に本当に役立つことより、とにかく長く使わせるほうが有利になるかもしれません。
AIが命令を無視しているとは限りません。決められた条件へ忠実に最適化した結果、本来の目的との間にズレが生まれることがあります。
AIアラインメントでは何を調整する?
アラインメントで調整しようとする対象は、利用者から受け取った指示だけではありません。
指示への対応、安全性や行動原則、人間による評価や監督など、複数の側面からAIの振る舞いを望ましい方向へ近づけます。
1. 人間が出した指示や意図に近づける
最も身近なのは、利用者が「何をしてほしいのか」をAIが適切にくみ取ることです。
「文章を短くして」と言われたとき、意味がなくなるほど削るのではなく、重要な内容を残しながら短くする、といった違いです。
このような調整に使われてきた代表的な方法の一つが、RLHF(Reinforcement Learning from Human Feedback、人間のフィードバックによる強化学習)です。
人間が複数の回答を比べ、「こちらのほうが望ましい」と評価し、その情報をモデルの学習に利用します。
人間がすべての正解を細かくプログラムしなくても、比較や評価を通して望ましい方向へ近づけられる点が特徴です。
一方、人間の評価も完全ではありません。
評価する人が間違いを見落としたり、専門知識が必要な内容を正しく判定できなかったりする可能性があります。AIが評価者の専門性を上回る領域では、人間側が回答の正しさを十分に評価すること自体が難しくなる可能性もあります。
そこで研究されているのが、AIの能力が高まっても人間による監督を機能させる方法です。英語では「scalable oversight」と呼ばれます。
2. 安全性や行動原則を反映させる
利用者の指示に従うことだけを最優先すると、それ自体が問題になる場合もあります。
危険な要求や他者へ害を及ぼす用途まで無条件に実行するAIは、目の前の利用者には従っていても、より広い意味で望ましいAIとはいえません。
そこで、AIに従ってほしい原則を文章で示し、学習や振る舞いの調整に利用する方法もあります。
Anthropicが研究してきた「Constitutional AI」はその一例で、AIへ行動原則を示し、それを学習に利用する方法です。「憲法AI」と訳されることもあります。
Anthropicは2026年1月にClaudeの新しい憲法を公開し、モデルに求める価値や振る舞いを文章化しています。
原則を文章にしたとしても、実際のモデルが常にそのとおり振る舞うとは限りません。学習後に振る舞いを確かめることも必要になります。
3. 評価や監視によってズレを見つける
AIアラインメントは、望ましい振る舞いを学習させれば終わりではありません。
完成したモデルをさまざまな条件で試し、通常の利用では見つけにくい問題がないかを調べる評価や監査も行われています。
2026年にはOpenAIも、長時間動作するモデルの限定的な内部利用で、事前評価では捉えられなかった問題を確認し、新しい評価や監視を追加した事例を公表しています。
モデルの能力や利用方法が変われば、それまで見えていなかった振る舞いが現れる場合もあります。
AIをどう学習させたかだけでなく、実際にどのように振る舞っているのかを継続して調べることも、アラインメントの一部です。
AIアラインメントを難しくする人間の価値観の多様さ
「AIを人間に合わせればよい」と聞くと、正しい価値観をAIへ教えれば解決するようにも思えます。
しかし、人間の価値観は一枚岩ではありません。
国や文化、立場、状況によって、何を公平と考えるのか、どこまで自由を優先するのか、どの程度の危険を許容するのかは変わります。
Google DeepMindも、人々が多様な価値観を持つ社会では、AIへ何の価値や原則を組み込むべきか自体が課題になると論じています。
AIへ与える原則にも、それを作成した人や組織の判断が入ります。
さらに、複数の原則が同時に当てはまる場合には、どちらを優先するのかという問題も出てきます。
たとえば、利用者の希望を尊重することと、安全性を優先することがぶつかれば、どちらをどこまで重視するのかを決めなければなりません。
つまり「人間に合わせる」といっても、誰の意図や価値を、どの場面で、どの程度優先するのかまで考える必要があります。
加えて、AIが人間の専門性を上回るような領域では、利用者や評価者がAIの判断を十分に検証できるとは限りません。
人間の価値観の違いと、人間による評価の限界。この両方が、AIアラインメントを難しい課題にしています。
AIアラインメントとAI安全性は同じもの?
AIアラインメントと「AI安全性」は関係が深いものの、完全に同じ意味ではありません。
用語が指す範囲は研究者や組織によって異なりますが、多くの場合、アラインメントはAI安全性と深く関係する課題の一つとして扱われます。
AIアラインメントでは主に、人間の意図や価値とAIの振る舞いのズレをどう小さくするかが問題になります。
一方、AIを安全で信頼できる形で利用するには、アラインメント以外にもさまざまな課題があります。
たとえば、
- セキュリティ
- プライバシー
- システムの信頼性
- 透明性や説明可能性
- 不公平な偏り
- 不正利用への対策
などです。
NIST(米国国立標準技術研究所)のAIリスク管理フレームワークでも、AIを信頼できる形で扱うために、安全性だけでなく、信頼性、セキュリティ、透明性、説明可能性、プライバシー、公平性など複数の観点を扱っています。
2026年9月時点では、2023年に公表されたAIリスク管理フレームワーク1.0の改訂作業も進められています。
AIアラインメントはAI安全性を考えるうえで大きなテーマの一つですが、AIに関するすべての安全問題を表す言葉ではありません。
まとめ
AIアラインメントとは、AIの目的や振る舞いと、人間が本当に望んでいる意図・価値・結果とのズレを小さくしようとする考え方です。
難しいのは、AIが指示を無視する場合だけではありません。設定された条件へ忠実に動いた結果、本来の目的から外れることもあります。
そのため、人間のフィードバックを使った学習、文章化した行動原則、テスト、監視、モデルの評価など、複数の方法が組み合わされています。
それでも、人間の評価には限界があり、何を望ましい価値と考えるかも一つではありません。AIが人間の専門性を上回る領域では、その振る舞いをどう評価し、監督するのかも課題になります。
AIに何をさせるかだけではなく、「本当は何を望んでいるのか」「AIがその方向へ進んでいるとどう確かめるのか」まで考える。それがAIアラインメントというテーマです。
参考情報
- OpenAI「How we think about safety and alignment」
- OpenAI「Aligning language models to follow instructions」
- OpenAI「Safety and alignment in an era of long-horizon models」
- Google DeepMind「Artificial Intelligence, Values and Alignment」
- Google DeepMind「Specification gaming: the flip side of AI ingenuity」
- Anthropic「Constitutional AI: Harmlessness from AI Feedback」
- Anthropic「Claude’s new constitution」
- National Institute of Standards and Technology(NIST)「AI Risk Management Framework」